0%

Docker 和 Kubernetes(k8s)

Docker 和 Kubernetes(k8s)都是容器化技术的关键组件,但它们在容器生态系统中起到不同的作用。

Docker
  1. Docker 是一种容器技术,它允许开发者将应用程序及其依赖项打包到一个容器中。这有助于实现应用程序的隔离和一致性。
  2. Docker 提供了一个轻量级的虚拟化方式,让应用程序在不同环境中以相同的方式运行,从而简化了开发、测试和部署过程。
  3. Docker 主要关注单个容器的创建、管理和运行。

Kubernetes(k8s):
  1. Kubernetes 是一个容器编排平台,用于自动化容器部署、扩展和管理。它的主要目标是简化大规模容器应用程序的管理。
  2. Kubernetes 能够在多个节点上调度、管理和扩展容器,实现容器的负载均衡和自动恢复。
  3. Kubernetes 提供了一整套功能,如服务发现、存储管理、自动扩容、滚动更新等,以支持容器应用程序的生命周期管理。

总结起来,Docker 是一种容器技术,用于将应用程序及其依赖项封装到单独的容器中。而 Kubernetes 是一个容器编排和管理平台,用于部署和管理大规模的容器化应用程序。这两个技术互补,通常一起使用以实现现代、可扩展的应用程序部署。

一、初识Docker

1.1.什么是Docker

微服务虽然具备各种各样的优势,但服务的拆分通用给部署带来了很大的麻烦。

  • 分布式系统中,依赖的组件非常多,不同组件之间部署时往往会产生一些冲突。
  • 在数百上千台服务中重复部署,环境不一定一致,会遇到各种问题

1.1.1.应用部署的环境问题

大型项目组件较多,运行环境也较为复杂,部署时会碰到一些问题:

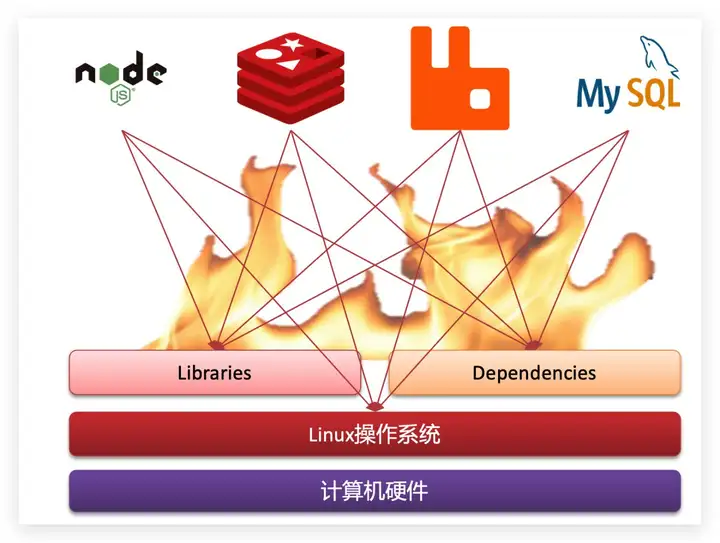
  • 依赖关系复杂,容易出现兼容性问题
  • 开发、测试、生产环境有差异

例如一个项目中,部署时需要依赖于node.js、Redis、RabbitMQ、MySQL等,这些服务部署时所需要的函数库、依赖项各不相同,甚至会有冲突。给部署带来了极大的困难。

1.1.2.Docker解决依赖兼容问题

而Docker确巧妙的解决了这些问题,Docker是如何实现的呢?

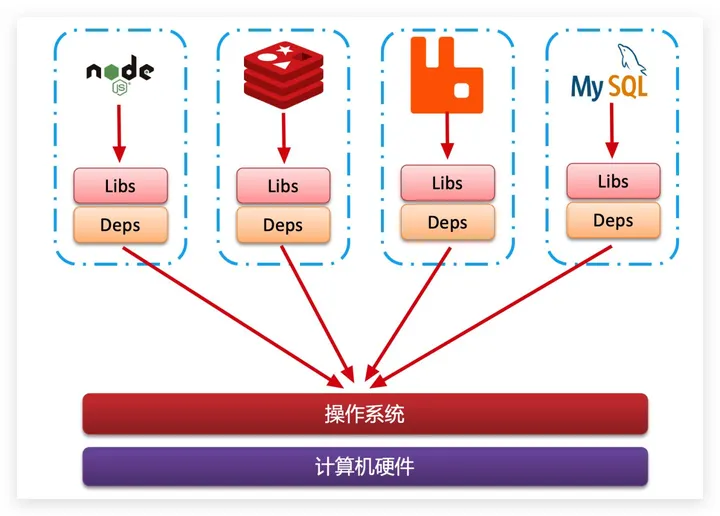
Docker为了解决依赖的兼容问题的,采用了两个手段:

  • 将应用的Libs(函数库)、Deps(依赖)、配置与应用一起打包
  • 将每个应用放到一个隔离容器去运行,避免互相干扰

​

这样打包好的应用包中,既包含应用本身,也保护应用所需要的Libs、Deps,无需再操作系统上安装这些,自然就不存在不同应用之间的兼容问题了。

虽然解决了不同应用的兼容问题,但是开发、测试等环境会存在差异,操作系统版本也会有差异,怎么解决这些问题呢?

1.1.3.Docker解决操作系统环境差异

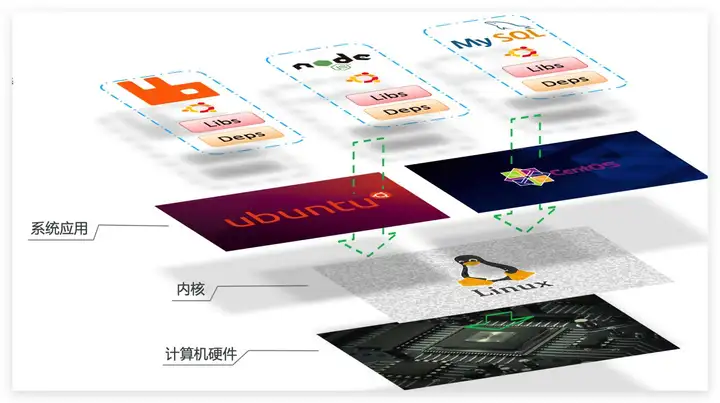
要解决不同操作系统环境差异问题,必须先了解操作系统结构。以一个Ubuntu操作系统为例,结构如下:
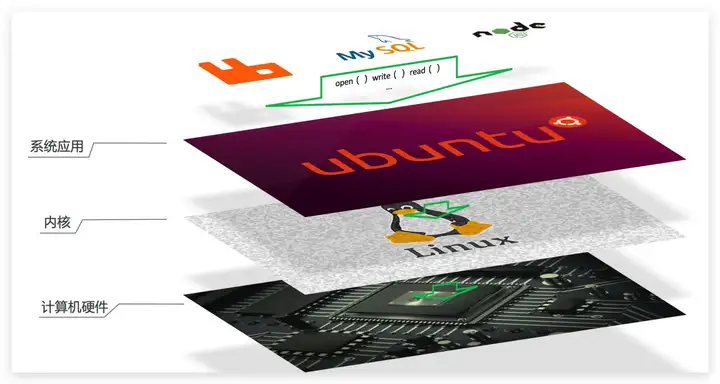
结构包括:

  • 计算机硬件:例如CPU、内存、磁盘等
  • 系统内核:所有Linux发行版的内核都是Linux,例如CentOS、Ubuntu、Fedora等。内核可以与计算机硬件交互,对外提供内核指令,用于操作计算机硬件。
  • 系统应用:操作系统本身提供的应用、函数库。这些函数库是对内核指令的封装,使用更加方便。

应用于计算机交互的流程如下:

1)应用调用操作系统应用(函数库),实现各种功能

2)系统函数库是对内核指令集的封装,会调用内核指令

3)内核指令操作计算机硬件

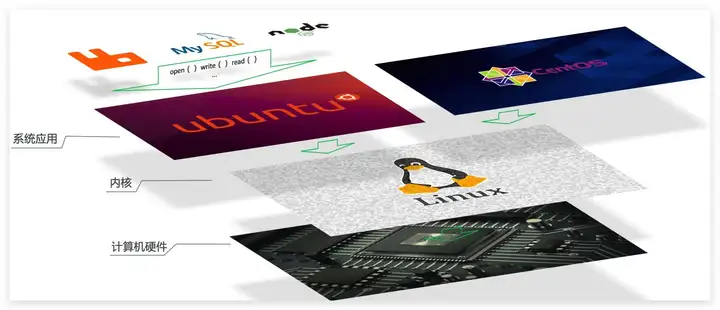
Ubuntu和CentOSpringBoot都是基于Linux内核,无非是系统应用不同,提供的函数库有差异:
​

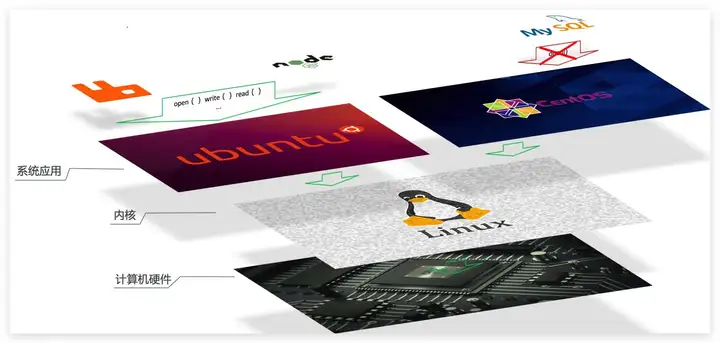
此时,如果将一个Ubuntu版本的MySQL应用安装到CentOS系统,MySQL在调用Ubuntu函数库时,会发现找不到或者不匹配,就会报错了:
​

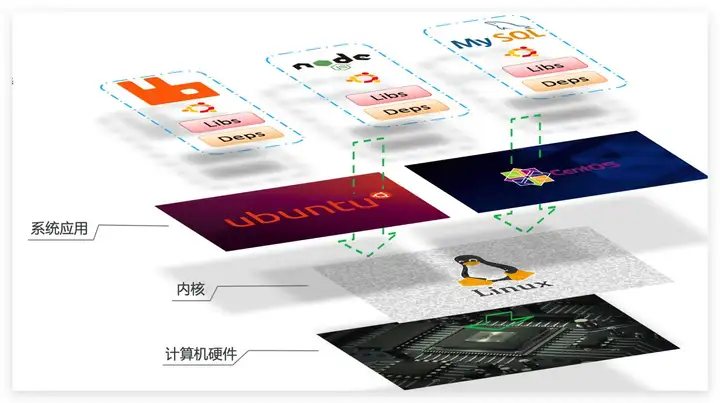
Docker如何解决不同系统环境的问题?

  • Docker将用户程序与所需要调用的系统(比如Ubuntu)函数库一起打包
  • Docker运行到不同操作系统时,直接基于打包的函数库,借助于操作系统的Linux内核来运行

如图:
​

1.1.4.小结

Docker如何解决大型项目依赖关系复杂,不同组件依赖的兼容性问题?

  • Docker允许开发中将应用、依赖、函数库、配置一起打包,形成可移植镜像
  • Docker应用运行在容器中,使用沙箱机制,相互隔离

Docker如何解决开发、测试、生产环境有差异的问题?

  • Docker镜像中包含完整运行环境,包括系统函数库,仅依赖系统的Linux内核,因此可以在任意Linux操作系统上运行

Docker是一个快速交付应用、运行应用的技术,具备下列优势:

  • 可以将程序及其依赖、运行环境一起打包为一个镜像,可以迁移到任意Linux操作系统
  • 运行时利用沙箱机制形成隔离容器,各个应用互不干扰
  • 启动、移除都可以通过一行命令完成,方便快捷

1.2.Docker和虚拟机的区别

Docker可以让一个应用在任何操作系统中非常方便的运行。而以前我们接触的虚拟机,也能在一个操作系统中,运行另外一个操作系统,保护系统中的任何应用。

两者有什么差异呢?

虚拟机(virtual machine)是在操作系统中模拟硬件设备,然后运行另一个操作系统,比如在 Windows 系统里面运行 Ubuntu 系统,这样就可以运行任意的Ubuntu应用了。

Docker仅仅是封装函数库,并没有模拟完整的操作系统,如图:
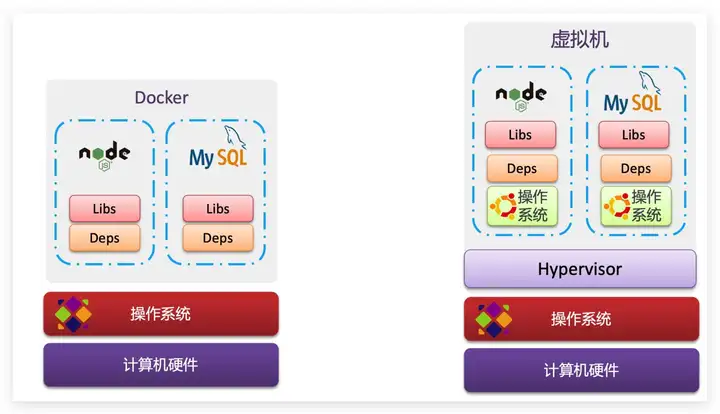
对比来看:
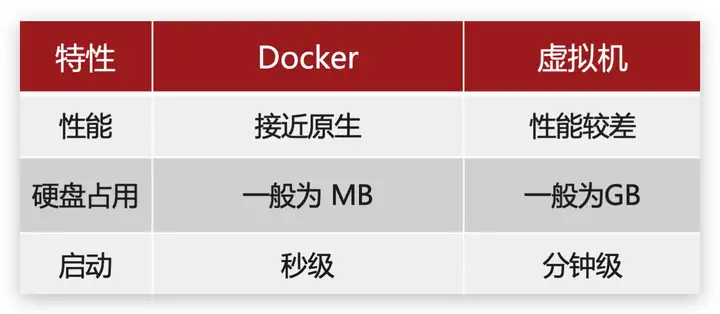
​

小结:

Docker和虚拟机的差异:

  • docker是一个系统进程;虚拟机是在操作系统中的操作系统
  • docker体积小、启动速度快、性能好;虚拟机体积大、启动速度慢、性能一般

1.3.Docker架构

1.3.1.镜像和容器

Docker中有几个重要的概念:

镜像(Image):Docker将应用程序及其所需的依赖、函数库、环境、配置等文件打包在一起,称为镜像。

容器(Container):镜像中的应用程序运行后形成的进程就是容器,只是Docker会给容器进程做隔离,对外不可见。

一切应用最终都是代码组成,都是硬盘中的一个个的字节形成的文件。只有运行时,才会加载到内存,形成进程。

而镜像,就是把一个应用在硬盘上的文件、及其运行环境、部分系统函数库文件一起打包形成的文件包。这个文件包是只读的。

容器呢,就是将这些文件中编写的程序、函数加载到内存中允许,形成进程,只不过要隔离起来。因此一个镜像可以启动多次,形成多个容器进程。
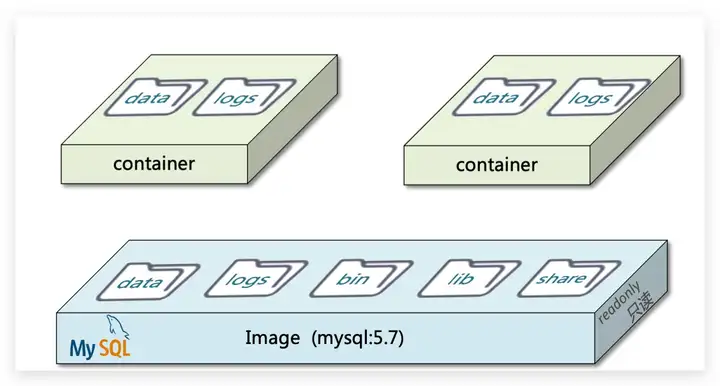
​

例如你下载了一个QQ,如果我们将QQ在磁盘上的运行文件及其运行的操作系统依赖打包,形成QQ镜像。然后你可以启动多次,双开、甚至三开QQ,跟多个妹子聊天。

1.3.2.DockerHub

开源应用程序非常多,打包这些应用往往是重复的劳动。为了避免这些重复劳动,人们就会将自己打包的应用镜像,例如Redis、MySQL镜像放到网络上,共享使用,就像GitHub的代码共享一样。

  • DockerHub:DockerHub是一个官方的Docker镜像的托管平台。这样的平台称为Docker Registry。
  • 国内也有类似于DockerHub 的公开服务,比如 网易云镜像服务、阿里云镜像库等。

我们一方面可以将自己的镜像共享到DockerHub,另一方面也可以从DockerHub拉取镜像:
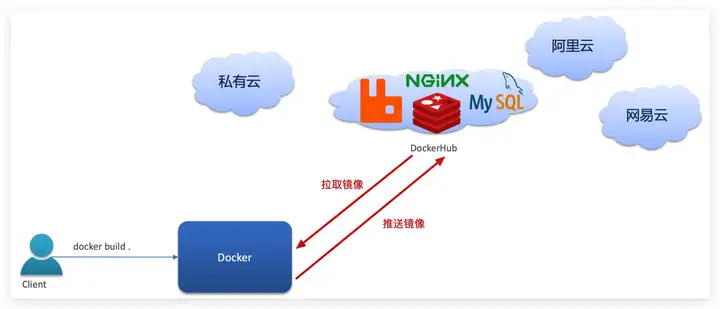
​

1.3.3.Docker架构

我们要使用Docker来操作镜像、容器,就必须要安装Docker。

Docker是一个CS架构的程序,由两部分组成:

  • 服务端(server):Docker守护进程,负责处理Docker指令,管理镜像、容器等
  • 客户端(client):通过命令或RestAPI向Docker服务端发送指令。可以在本地或远程向服务端发送指令。

如图:
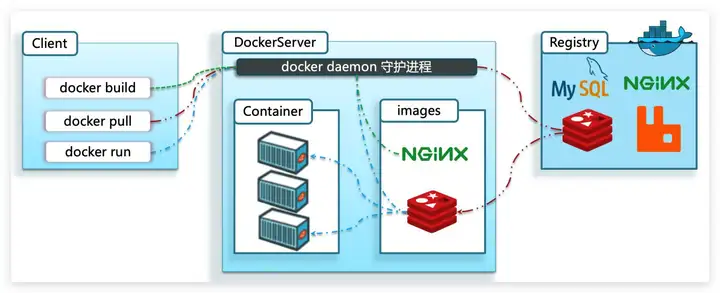
1.3.4.小结

镜像:

  • 将应用程序及其依赖、环境、配置打包在一起

容器:

  • 镜像运行起来就是容器,一个镜像可以运行多个容器

Docker结构:

  • 服务端:接收命令或远程请求,操作镜像或容器
  • 客户端:发送命令或者请求到Docker服务端

DockerHub:

  • 一个镜像托管的服务器,类似的还有阿里云镜像服务,统称为DockerRegistry1.4.安装Docker

二、 Kubernetes的概念

Kubernetes(k8s)是一个基于容器技术的的分布式架构解决方案,是Google开源的容器集群管理系统,Google内部称为Borg,主要用于自动部署、扩展和管理容器化的应用程序,是以Docer为基础的分布式系统架构。 Kubernetes可以对分布式系统进行完美的支撑,它具备完善的集群控制能力,内建有智能的负载均衡器,拥有强大的故障发现和自我修复能力。同时还针对开发、部署测试、运维监控等提供了完善的管理工具。

Kubernetes的核心思想是:一切以服务为中心,根据这一核心思想,Kubernetes可以让在其上构建的系统独立运行在物理机、虚拟机群或者云上,所以,Service(服务)是Kubernetes进行分布式集群构建的核心,必须拥有如下关键特征:

  • 拥有一个唯一指定的名称。
  • 拥有一个虚拟IP和端口。
  • 能够提供某种远程服务能力。
  • 可以被映射到提供这种远程服务能力的一组容器应用上。

三、Kubernetes的术语

3.1 Master

Kubernetes的集群控制节点,负责整个集群的管理和控制,拥有一个etcd服务,用来保存所有资源对象的数据,我们执行的所有控制命令会发给他,他负责具体的执行过程,Master节点通常会独占一个服务器,在其上会运行以上一组关键的进程:

  • Kubernetes API Server:提供Http Rest接口的关键服务进程,是Kubernetes中增、删、改、查等操作的唯一入口,是集群控制的入口进程。
  • Kubernetes Controller Manager:Kubernetes中所有资源对象的自动化控制中心。
  • Kubernetes Scheduler:负责资源调度的进程。

3.2 Node

Kubernetes集群中的其他机器被称为Node节点,Node节点可以是一台物理主机,也可以是一台虚拟机,每个Node节点会被Master节点分配一些负载,所以Node节点是Kubernetes集群中工作负载节点,当某个Node节点宕机时,工作负载会被Master自动转移到其他节点。Node节点之上会运行一组关键进程:

  • kubelet:负责Pod对应容器的创建,启动、停止等任务。
  • kube-proxy:实现Kubernetes Service通讯与负载均衡机制的重要组件。
  • Docker Engine:Docker引擎,负责容器的创建和管理

3.3 Pod

Pod是Kurbernetes进行创建、调度和管理的最小单位,Pod运行在Node节点之上,其中包含多个业务容器,这些业务容器之间共享网络命名空间、Ip地址、端口,可以通过localhost进行通讯。Pod有两种类型:普通Pod和静态Pod。

3.4 Replication Controller

Kurbernetes用来管理和保证集群中拥有的Pod。

四、 Kubernetes的架构

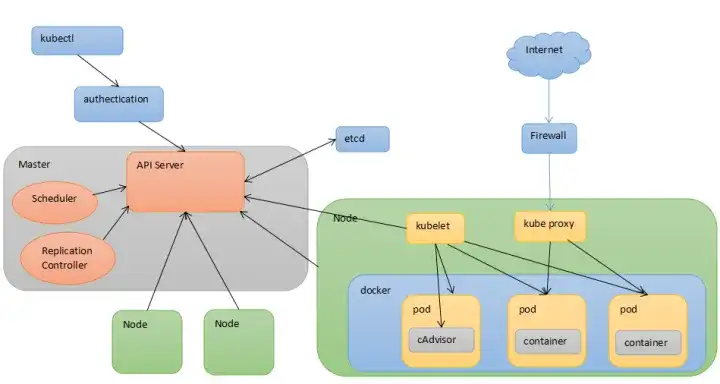
Kubernetes的一切都是基于分布式的,下面这张图就是Kubernetes的架构图
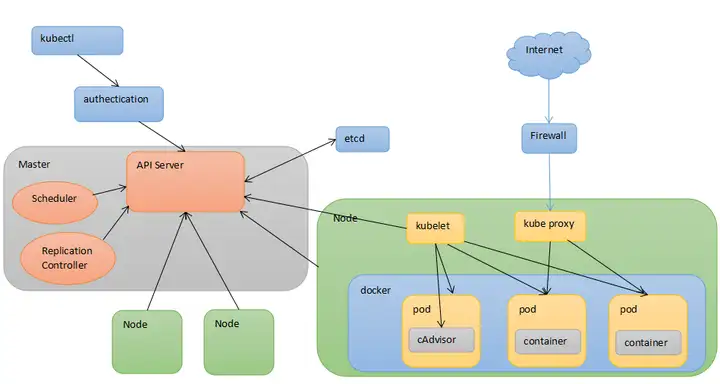
通过这张架构图我们发现Kurbernetes主要由以下几个核心组件组成:

  • Etcd:保存整个集群的状态。
  • API Server:提供认证、授权、访问控制、API注册和发现等机制,是资源操作的唯一入口。
  • Kurbernetes Controller:负责维护集群的状态。
  • Scheduler:负责资源的调度。
  • **kubelet**:负责维护容器的生命周期,同时管理Volume和网络。
  • Container:负责镜像管理以及Pod和容器的真正运行。
  • kube-proxy:负责为Service提供cluster内部的服务发现和负载均衡。

docker安装部署手册

十分钟学会用docker部署微服务 - 知乎 (zhihu.com)

史上最全Docker环境安装指南 - 知乎 (zhihu.com) (docker 安装)
K8S部署手册

kubernetes(k8s)集群超级详细超全安装部署手册 - 知乎 (zhihu.com)

source:Tianshou–强化学习算法框架学习笔记 - 知乎 (zhihu.com)

Cheat Sheet — Tianshou 0.5.1 documentation

欢迎查看天授平台中文文档 — 天授 0.4.6.post1 文档 (tianshou.readthedocs.io)

一、Tianshou的基本框架

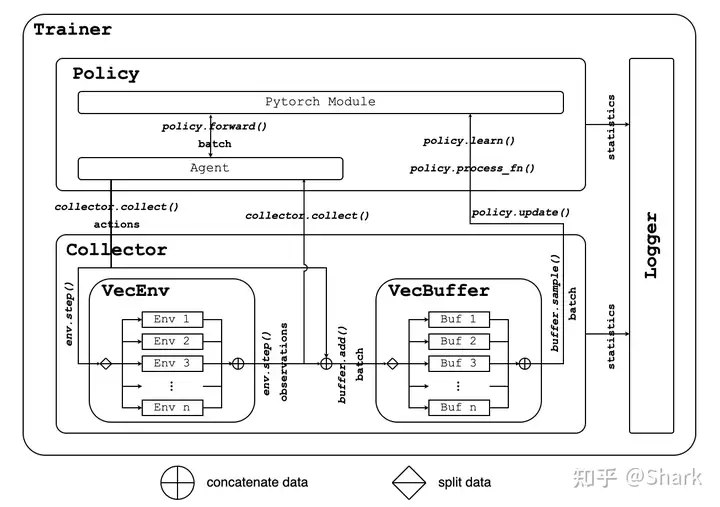
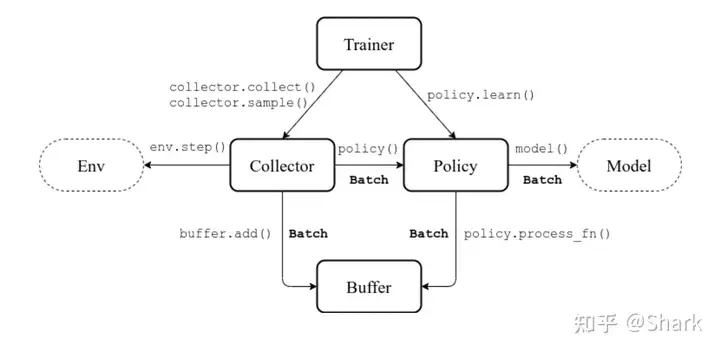
天授(Tianshou)把一个RL训练流程划分成了几个子模块:trainer(负责训练逻辑)、collector(负责数据采集)、policy(负责训练策略)和 buffer(负责数据存储),此外还有两个外围的模块,一个是env,一个是model(policy负责RL算法实现比如loss function的计算,model就只是个正常的神经网络)。下图描述了这些模块的依赖:

https://pic2.zhimg.com/80/v2-da45fbece6e91c073061d6b0b82ae50d_720w.webp

例子:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
import gymnasium as gym
import numpy as np
import tianshou as ts
import torch
from torch import nn
from torch.utils.tensorboard import SummaryWriter
from tianshou.utils import TensorboardLogger
​
​
class Net(nn.Module):
def __init__(self, state_shape, action_shape):
super().__init__()
self.model = nn.Sequential(
nn.Linear(np.prod(state_shape), 128), nn.ReLU(inplace=True),
nn.Linear(128, 128), nn.ReLU(inplace=True),
nn.Linear(128, np.prod(action_shape)),
)
​
def forward(self, obs, state=None, info={}):
if not isinstance(obs, torch.Tensor):
obs = torch.tensor(obs, dtype=torch.float)
batch = obs.shape[0]
logits = self.model(obs.view(batch, -1))
return logits, state
​
​
# Make an environment
env = gym.make('CartPole-v1')
state_shape = env.observation_space.shape[0]
action_shape = env.action_space.n
​
# Build the Network
net = Net(state_shape, action_shape)
optim = torch.optim.Adam(net.parameters(), lr=1e-3)
​
# Setup Policy
policy = ts.policy.DQNPolicy(net, optim, discount_factor=0.9, estimation_step=3, target_update_freq=320)
​
# Setup Collector
train_collector = ts.data.Collector(policy, env, ts.data.ReplayBuffer(20000, 10), exploration_noise=True)
test_collector = ts.data.Collector(policy, env, exploration_noise=True)
​
# logging
# writer = SummaryWriter('log/dqn')
# logger = TensorboardLogger(writer)
​
# Train Policy with a Trainer
result = ts.trainer.offpolicy_trainer(
policy, train_collector, test_collector,
max_epoch=10, step_per_epoch=10000, step_per_collect=10,
update_per_step=0.1, episode_per_test=100, batch_size=64,
train_fn=lambda epoch, env_step: policy.set_eps(0.1),
test_fn=lambda epoch, env_step: policy.set_eps(0.05),
stop_fn=lambda mean_rewards: mean_rewards >= env.spec.reward_threshold)
print(f'Finished training! Use {result["duration"]}')

下面,我们就将一步一步的了解上图中所有的API,对Tianshou有一个大致的了解。

二、Batch

下面我们首先来看看Batch这个数据结构:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
import numpy as np
from tianshou.data import Batch
data = Batch(a=4, b=[5, 5], c='2312312', d=('a', -2, -3))
print(data)
print(data.b)
​
"""
Batch(
a: array(4),
b: array([5, 5]),
c: '2312312',
d: array(['a', '-2', '-3'], dtype=object),
)
[5 5]
"""

可以发现,batch类似于dict,存储key-value对,并且可以自动将value转化成numpy array。

下面例子演示Batch存储numpy和pytorch的数据:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
import torch
batch1 = Batch(a=np.arange(2), b=torch.zeros((2,2)))
batch2 = Batch(a=np.arange(2), b=torch.ones((2,2)))
batch_cat = Batch.cat([batch1, batch2, batch1])
print(batch1)
print(batch2)
print(batch_cat)
"""
Batch(
a: array([0, 1]),
b: tensor([[0., 0.],
[0., 0.]]),
)
Batch(
a: array([0, 1]),
b: tensor([[1., 1.],
[1., 1.]]),
)
Batch(
b: tensor([[0., 0.],
[0., 0.],
[1., 1.],
[1., 1.],
[0., 0.],
[0., 0.]]),
a: array([0, 1, 0, 1, 0, 1]),
)
"""

将Batch中的数据类型统一转换成numpy或pytorch的数据类型:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
batch_cat.to_numpy()
print(batch_cat)
batch_cat.to_torch()
print(batch_cat)
"""
Batch(
a: array([0, 1, 0, 1, 0, 1]),
b: array([[0., 0.],
[0., 0.],
[1., 1.],
[1., 1.],
[0., 0.],
[0., 0.]], dtype=float32),
)
Batch(
a: tensor([0, 1, 0, 1, 0, 1]),
b: tensor([[0., 0.],
[0., 0.],
[1., 1.],
[1., 1.],
[0., 0.],
[0., 0.]]),
)
"""

三、ReplayBuffer

Replay buffer在RL的off-policy中非常常用,其可以存储过去的经验,以便训练我们的agent。

在Tianshou中,可以把replay buffer看成一种特殊的Batch。

下面是使用replay buffer的例子:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
from tianshou.data import Batch, ReplayBuffer
​
# a buffer is initialised with its maxsize set to 10 (older data will be discarded if more data flow in).
print("========================================")
buf = ReplayBuffer(size=10)
print(buf)
print("maxsize: {}, data length: {}".format(buf.maxsize, len(buf)))
​
# add 3 steps of data into ReplayBuffer sequentially
print("========================================")
for i in range(3):
buf.add(Batch(obs=i, act=i, rew=i, done=0, obs_next=i + 1, info={}))
print(buf)
print("maxsize: {}, data length: {}".format(buf.maxsize, len(buf)))
​
# add another 10 steps of data into ReplayBuffer sequentially
print("========================================")
for i in range(3, 13):
buf.add(Batch(obs=i, act=i, rew=i, done=0, obs_next=i + 1, info={}))
print(buf)
print("maxsize: {}, data length: {}".format(buf.maxsize, len(buf)))
"""
========================================
ReplayBuffer()
maxsize: 10, data length: 0
========================================
ReplayBuffer(
info: Batch(),
obs_next: array([1, 2, 3, 0, 0, 0, 0, 0, 0, 0]),
act: array([0, 1, 2, 0, 0, 0, 0, 0, 0, 0]),
obs: array([0, 1, 2, 0, 0, 0, 0, 0, 0, 0]),
done: array([False, False, False, False, False, False, False, False, False,
False]),
rew: array([0., 1., 2., 0., 0., 0., 0., 0., 0., 0.]),
)
maxsize: 10, data length: 3
========================================
ReplayBuffer(
info: Batch(),
obs_next: array([11, 12, 13, 4, 5, 6, 7, 8, 9, 10]),
act: array([10, 11, 12, 3, 4, 5, 6, 7, 8, 9]),
obs: array([10, 11, 12, 3, 4, 5, 6, 7, 8, 9]),
done: array([False, False, False, False, False, False, False, False, False,
False]),
rew: array([10., 11., 12., 3., 4., 5., 6., 7., 8., 9.]),
)
maxsize: 10, data length: 10
"""

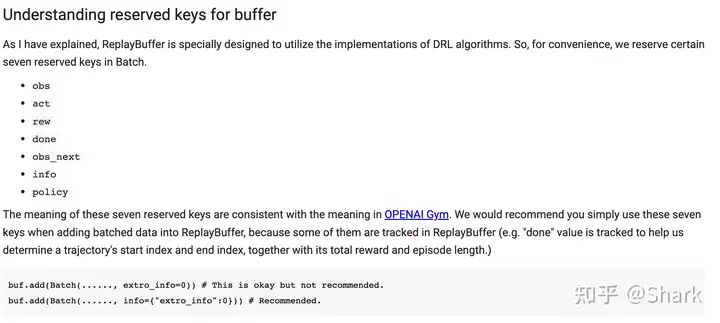
replay buffer中保留了七个属性,Tianshou推荐我们使用这七个推荐的属性,而不是自己去创建其他属性。

我们也看到了,buffer其实就是一种特殊的Batch,那他存在的意义是什么呢?

就在于可以从buffer中sample数据给到collector中,供agent进行训练。

现在Tianshou支持gymnasium,所以又多了两个属性:truncated和terminated。

我们还可以高效的从buffer中追踪trajectory信息。

下面这段代码可以获得下标为6的step所处的episode的第一个step的下标

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
# Search for the previous index of index "6"
now_index = 6
while True:
prev_index = buf.prev(now_index)
print(prev_index)
if prev_index == now_index:
break
else:
now_index = prev_index
"""
5
4
3
3
"""

同理,下面代码可以返回在当前episode中下一个step的下标:

1
2
3
4
5
6
7
# next step of indexes [4,5,6,7,8,9] are:
print(buf.next([4,5,6,7,8,9]))
print(buf.next(7))
"""
[5 6 7 7 9 0]
7
"""

这在n-step-return的时候非常有用(n-step TD)

四、Vectorized Environment

在gym中,环境接收一个动作,返回下一个状态的观测和奖励。这个过程很慢,并且常常是实验的性能瓶颈,所以Tianshou利用并行环境加速这一过程。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
from tianshou.env import SubprocVectorEnv
import numpy as np
import gym
import time
​
num_cpus = [1,2,5]
for num_cpu in num_cpus:
# SubprocVectorEnv这个wrapper利用多个进程,并行执行多个环境。
env = SubprocVectorEnv([lambda: gym.make('CartPole-v0') for _ in range(num_cpu)])
env.reset()
sampled_steps = 0
time_start = time.time()
while sampled_steps < 1000:
act = np.random.choice(2, size=num_cpu)
obs, rew, done, info = env.step(act)
if np.sum(done):
env.reset(np.where(done)[0])
sampled_steps += num_cpu
time_used = time.time() - time_start
print("{}s used to sample 1000 steps if using {} cpus.".format(time_used, num_cpu))

下面是单个环境与多个环境的对比:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
from tianshou.env import DummyVectorEnv
# In Gym
env = gym.make("CartPole-v0")
​
# In Tianshou
def helper_function():
env = gym.make("CartPole-v0")
# other operations such as env.seed(np.random.choice(10))
return env
​
envs = DummyVectorEnv([helper_function for _ in range(5)])
​
# In Gym, env.reset() returns a single observation.
print("In Gym, env.reset() returns a single observation.")
print(env.reset())
​
# In Tianshou, envs.reset() returns stacked observations.
print("========================================")
print("In Tianshou, envs.reset() returns stacked observations.")
print(envs.reset())
​
obs, rew, done, info = envs.step(np.random.choice(2, size=num_cpu))
print(info)
"""
In Gym, env.reset() returns a single observation.
[0.04703292 0.03945684 0.03802961 0.02598534]
========================================
In Tianshou, envs.reset() returns stacked observations.
[[ 0.04029649 -0.01946092 -0.02980652 -0.01614117]
[-0.03085166 -0.04178732 -0.02325586 0.00156881]
[ 0.00672287 0.04306572 0.01217845 -0.04455359]
[ 0.03829754 0.02683093 -0.01153483 0.04290532]
[ 0.04420044 0.00097068 -0.01117315 0.04102308]]
[{'env_id': 0} {'env_id': 1} {'env_id': 2} {'env_id': 3} {'env_id': 4}]
"""

五、Policy

Policy就是agent如何做出action的\pi函数。

所有Policy模块都继承自BasePolicy类,并且具有相同的接口。

下面我们就来看看如何实现一个简单的REINFORCE的policy。

1
2
3
4
5
6
7
8
9
10
11
12
from typing import Any, Dict, List, Optional, Type, Union
​
import numpy as np
import torch
​
from tianshou.data import Batch, ReplayBuffer, to_torch, to_torch_as
from tianshou.policy import BasePolicy
​
class REINFORCEPolicy(BasePolicy):
"""Implementation of REINFORCE algorithm."""
def __init__(self):
super().__init__()

policy最重要的两个功能就是

  1. 选择动作(forward)
  2. 更新参数(update),update先调用process_fn函数,处理从buffer来的数据;然后调用learn,反向传播,更新参数。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
from typing import Any, Dict, List, Optional, Type, Union
​
import numpy as np
import torch
​
from tianshou.data import Batch, ReplayBuffer, to_torch, to_torch_as
from tianshou.policy import BasePolicy
​
​
class REINFORCEPolicy(BasePolicy):
"""Implementation of REINFORCE algorithm."""
def __init__(self, model: torch.nn.Module, optim: torch.optim.Optimizer,):
super().__init__()
self.actor = model
self.optim = optim
​
def forward(self, batch: Batch) -> Batch:
"""Compute action over the given batch data."""
act = None
return Batch(act=act)
​
def process_fn(self, batch: Batch, buffer: ReplayBuffer, indices: np.ndarray) -> Batch:
"""Compute the discounted returns for each transition."""
pass
​
def learn(self, batch: Batch, batch_size: int, repeat: int) -> Dict[str, List[float]]:
"""Perform the back-propagation."""
return

六、Collector

collector与policy和环境交互,在其内部,把envs和buffer有机的结合起来,封装了其中的数据交互。

Collector在训练(收集数据)时和评估策略时都可以使用。

Data Collecting:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
from tianshou.data import VectorReplayBuffer
​
train_env_num = 4
buffer_size = 100
train_envs = DummyVectorEnv([lambda: gym.make("CartPole-v0") for _ in range(train_env_num)])
replaybuffer = VectorReplayBuffer(buffer_size, train_env_num)
​
# 定义一个Collector
train_collector = Collector(policy, train_envs, replaybuffer)
​
# 利用Collector收集50个step的数据,自动存入replaybuffer中
collect_result = train_collector.collect(n_step=50)
​
# 下面我们可以从buffer中抽样数据
replaybuffer.sample(10)

Policy evaluation:

我们已经有了一个policy,现在我们想评估一下这个policy,看看reward情况等等。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
import gym
import numpy as np
import torch
​
from tianshou.data import Collector
from tianshou.env import DummyVectorEnv
from tianshou.policy import PGPolicy
from tianshou.utils.net.common import Net
from tianshou.utils.net.discrete import Actor
​
import warnings
warnings.filterwarnings('ignore')
​
env = gym.make("CartPole-v0")
test_envs = DummyVectorEnv([lambda: gym.make("CartPole-v0") for _ in range(2)])
​
# model
net = Net(env.observation_space.shape, hidden_sizes=[16,])
actor = Actor(net, env.action_space.shape)
optim = torch.optim.Adam(actor.parameters(), lr=0.0003)
​
policy = PGPolicy(actor, optim, dist_fn=torch.distributions.Categorical)
test_collector = Collector(policy, test_envs)
​
# 收集9个episode
collect_result = test_collector.collect(n_episode=9)
print(collect_result)
"""
{'n/ep': 9, 'n/st': 82, 'rews': array([ 9., 9., 9., 9., 8., 9., 9., 11., 9.]), 'lens': array([ 9, 9, 9, 9, 8, 9, 9, 11, 9]), 'idxs': array([0, 1, 0, 1, 0, 1, 0, 1, 0]), 'rew': 9.11111111111111, 'len': 9.11111111111111, 'rew_std': 0.7370277311900889, 'len_std': 0.7370277311900889}
"""
print("Rewards of 9 episodes are {}".format(collect_result["rews"]))
"""
Rewards of 9 episodes are [ 9. 9. 9. 9. 8. 9. 9. 11. 9.]
"""
print("Average episode reward is {}.".format(collect_result["rew"]))
"""
Average episode reward is 9.11111111111111.
"""
print("Average episode length is {}.".format(collect_result["len"]))
"""
Average episode length is 9.11111111111111.
"""

七、Trainer

Trainer是Tianshou中的顶层封装,它控制traning loop和对Policy的evaluation。Trainer控制Policy和Collector的交互。

Tianshou中包含三类Trainer:On-policy training, off-policy training, offline training.

下面是REINFORCE算法的整体流程(利用On-policy)。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
import gymnasium as gym
import numpy as np
import torch
​
from tianshou.data import Collector, VectorReplayBuffer
from tianshou.env import DummyVectorEnv
from tianshou.policy import PGPolicy
from tianshou.utils.net.common import Net
from tianshou.utils.net.discrete import Actor
​
import warnings
​
warnings.filterwarnings('ignore')
​
train_env_num = 4
buffer_size = 2000 # Since REINFORCE is an on-policy algorithm, we don't need a very large buffer size
​
# Create the environments, used for training and evaluation
env = gym.make("CartPole-v1")
test_envs = DummyVectorEnv([lambda: gym.make("CartPole-v1") for _ in range(2)])
train_envs = DummyVectorEnv([lambda: gym.make("CartPole-v1") for _ in range(train_env_num)])
​
# Create the Policy instance
net = Net(env.observation_space.shape, hidden_sizes=[16, ])
actor = Actor(net, env.action_space.shape)
optim = torch.optim.Adam(actor.parameters(), lr=0.001)
policy = PGPolicy(actor, optim, dist_fn=torch.distributions.Categorical)
​
# Create the replay buffer and the collector
replaybuffer = VectorReplayBuffer(buffer_size, train_env_num)
test_collector = Collector(policy, test_envs) # 可以发现,test_collector没有replaybuffer,因为不做训练,只是测试
train_collector = Collector(policy, train_envs, replaybuffer)
​
train_collector.reset()
train_envs.reset()
test_collector.reset()
test_envs.reset()
replaybuffer.reset()
for i in range(10): # 10 epoch
evaluation_result = test_collector.collect(n_episode=10) # test_collector用来测试当前policy,得出reward。
print("Evaluation reward is {}".format(evaluation_result["rew"]))
train_collector.collect(n_step=2000) # 收集2000个step到replaybuffer中
# 0 means taking all data stored in train_collector.buffer
policy.update(0, train_collector.buffer, batch_size=512, repeat=1) # buffer中所有数据,每次batch_size为512,
train_collector.reset_buffer(keep_statistics=True)
​
# 下面是使用tainer的代码:
train_collector.reset()
train_envs.reset()
test_collector.reset()
test_envs.reset()
replaybuffer.reset()
​
result = onpolicy_trainer(
policy,
train_collector,
test_collector,
max_epoch=10,
step_per_epoch=1, # 每个epoch进行多少次transitions
repeat_per_collect=1, # the number of repeat time for policy learning, for example, set it to 2 means the policy needs to learn each given batch data twice.
episode_per_test=10, # 每次测试进行几个episode
step_per_collect=2000, # 每次update前,收集多少step的数据
batch_size=512, # update的时候batch的大小
)
print(result)

可以发现,trainer就是包装了一下循环。

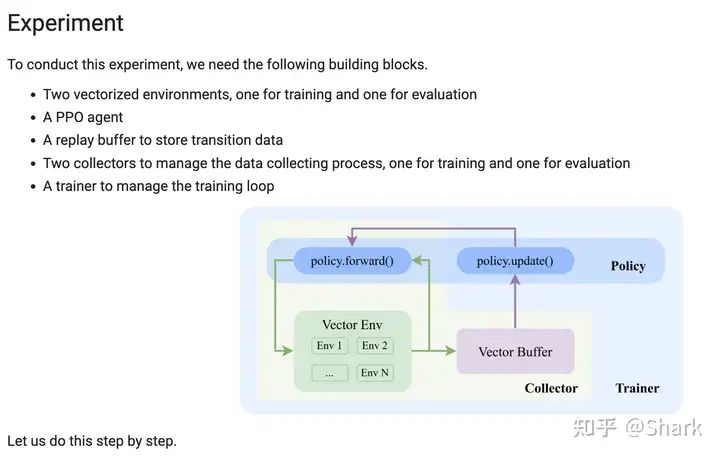
八、Experiment

这一节我们用PPO来解决CartPole

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
import gym
import numpy as np
import torch
​
from tianshou.data import Collector, VectorReplayBuffer
from tianshou.env import DummyVectorEnv
from tianshou.policy import PPOPolicy
from tianshou.trainer import onpolicy_trainer
from tianshou.utils.net.common import ActorCritic, Net
from tianshou.utils.net.discrete import Actor, Critic
​
import warnings
warnings.filterwarnings('ignore')
​
device = 'cuda' if torch.cuda.is_available() else 'cpu'
​
env = gym.make('CartPole-v0')
train_envs = DummyVectorEnv([lambda: gym.make('CartPole-v0') for _ in range(20)])
test_envs = DummyVectorEnv([lambda: gym.make('CartPole-v0') for _ in range(10)])
​
# net is the shared head of the actor and the critic
net = Net(env.observation_space.shape, hidden_sizes=[64, 64], device=device)
actor = Actor(net, env.action_space.n, device=device).to(device)
critic = Critic(net, device=device).to(device)
actor_critic = ActorCritic(actor, critic)
​
# optimizer of the actor and the critic
optim = torch.optim.Adam(actor_critic.parameters(), lr=0.0003)
​
dist = torch.distributions.Categorical
policy = PPOPolicy(actor, critic, optim, dist, action_space=env.action_space, deterministic_eval=True)
​
train_collector = Collector(policy, train_envs, VectorReplayBuffer(20000, len(train_envs)))
test_collector = Collector(policy, test_envs)
​
result = onpolicy_trainer(
policy,
train_collector,
test_collector,
max_epoch=10,
step_per_epoch=50000,
repeat_per_collect=10,
episode_per_test=10,
batch_size=256,
step_per_collect=2000,
stop_fn=lambda mean_reward: mean_reward >= 195,
)

vue 响应式界面真的很棒

介绍 — Vue.js (vuejs.org)

深入响应式系统深入响应式系统 | Vue.js (vuejs.org)

Vue 最标志性的功能就是其低侵入性的响应式系统。组件状态都是由响应式的 JavaScript 对象组成的。当更改它们时,视图会随即自动更新。这让状态管理更加简单直观,但理解它是如何工作的也是很重要的,这可以帮助我们避免一些常见的陷阱。在本节中,我们将深入研究 Vue 响应性系统的一些底层细节。

这个术语在今天的各种编程讨论中经常出现,但人们说它的时候究竟是想表达什么意思呢?本质上,响应性是一种可以使我们声明式地处理变化的编程范式。一个经常被拿来当作典型例子的用例即是 Excel 表格:

A B C
0
1
2

这里单元格 A2 中的值是通过公式 = A0 + A1 来定义的 (你可以在 A2 上点击来查看或编辑该公式),因此最终得到的值为 3,正如所料。但如果你试着更改 A0 或 A1,你会注意到 A2 也随即自动更新了。

而 JavaScript 默认并不是这样的。如果我们用 JavaScript 写类似的逻辑:

1
2
3
4
5
6
7
8
let A0 = 1
let A1 = 2
let A2 = A0 + A1

console.log(A2) // 3

A0 = 2
console.log(A2) // 仍然是 3

当我们更改 A0 后,A2 不会自动更新。

那么我们如何在 JavaScript 中做到这一点呢?首先,为了能重新运行计算的代码来更新 A2,我们需要将其包装为一个函数

let A2

function update() {
A2 = A0 + A1
}

然后,我们需要定义几个术语:

  • 这个 update() 函数会产生一个副作用,或者就简称为作用 (effect),因为它会更改程序里的状态。
  • A0 和 A1 被视为这个作用的依赖 (dependency),因为它们的值被用来执行这个作用。因此这次作用也可以说是一个它依赖的订阅者 (subscriber)。

我们需要一个魔法函数,能够在 A0 或 A1 (这两个依赖) 变化时调用 update() (产生作用)。

1
whenDepsChange(update)

这个 whenDepsChange() 函数有如下的任务:

  1. 当一个变量被读取时进行追踪。例如我们执行了表达式 A0 + A1 的计算,则 A0 和 A1 都被读取到了。
  2. 如果一个变量在当前运行的副作用中被读取了,就将该副作用设为此变量的一个订阅者。例如由于 A0 和 A1 在 update() 执行时被访问到了,则 update() 需要在第一次调用之后成为 A0 和 A1 的订阅者。
  3. 探测一个变量的变化。例如当我们给 A0 赋了一个新的值后,应该通知其所有订阅了的副作用重新执行。

Vue 中的响应性是如何工作的

我们无法直接追踪对上述示例中局部变量的读写,原生 JavaScript 没有提供任何机制能做到这一点。但是,我们是可以追踪对象属性的读写的。

在 JavaScript 中有两种劫持 property 访问的方式:getter / setters 和 Proxies。Vue 2 使用 getter / setters 完全是出于支持旧版本浏览器的限制。而在 Vue 3 中则使用了 Proxy 来创建响应式对象,仅将 getter / setter 用于 ref。下面的伪代码将会说明它们是如何工作的:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
function reactive(obj) {
return new Proxy(obj, {
get(target, key) {
track(target, key)
return target[key]
},
set(target, key, value) {
target[key] = value
trigger(target, key)
}
})
}

function ref(value) {
const refObject = {
get value() {
track(refObject, 'value')
return value
},
set value(newValue) {
value = newValue
trigger(refObject, 'value')
}
}
return refObject
}

以上代码解释了我们在基础章节部分讨论过的一些 reactive() 的局限性:

  • 当你将一个响应式对象的属性赋值或解构到一个本地变量时,访问或赋值该变量是非响应式的,因为它将不再触发源对象上的 get / set 代理。注意这种“断开”只影响变量绑定——如果变量指向一个对象之类的非原始值,那么对该对象的修改仍然是响应式的。
  • 从 reactive() 返回的代理尽管行为上表现得像原始对象,但我们通过使用 === 运算符还是能够比较出它们的不同。

在 track() 内部,我们会检查当前是否有正在运行的副作用。如果有,我们会查找到一个存储了所有追踪了该属性的订阅者的 Set,然后将当前这个副作用作为新订阅者添加到该 Set 中。

1
2
3
4
5
6
7
8
9
10
// 这会在一个副作用就要运行之前被设置
// 我们会在后面处理它
let activeEffect

function track(target, key) {
if (activeEffect) {
const effects = getSubscribersForProperty(target, key)
effects.add(activeEffect)
}
}

副作用订阅将被存储在一个全局的 WeakMap<target, Map<key, Set<effect>>> 数据结构中。如果在第一次追踪时没有找到对相应属性订阅的副作用集合,它将会在这里新建。这就是 getSubscribersForProperty() 函数所做的事。为了简化描述,我们跳过了它其中的细节。

在 trigger() 之中,我们会再查找到该属性的所有订阅副作用。但这一次我们需要执行它们:

1
2
3
4
function trigger(target, key) {
const effects = getSubscribersForProperty(target, key)
effects.forEach((effect) => effect())
}

单文件组件 Component可以理解为dom的一个标签

Vue 的单文件组件 (即 *.vue 文件,英文 Single-File Component,简称 SFC) 是一种特殊的文件格式,使我们能够将一个 Vue 组件的模板、逻辑与样式封装在单个文件中。下面是一个单文件组件的示例:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
<script>
export default {
data() {
return {
greeting: 'Hello World!'
}
}
}
</script>

<template>
<p class="greeting">{{ greeting }}</p>
</template>

<style>
.greeting {
color: red;
font-weight: bold;
}
</style>

1
2
# 测试代码块
import numpy as np

测试md文件

23年8月22日记

helloword

初始化博客

后续博客美化持续进行中